

从超级智能体,到超级智能团队
原创
AI安全迪哥
AI安全迪哥
AI安全迪哥
2026年11月8日 17:44
广东
去阅读
随着前段时间DeepSeek发布“Super-agent 设计探索:迈向更自主的 Agent 系统”的文章,超级智能体的概念又重新火热起来,今天结合DeepSeek以及Anthropic等实践,唠一会:「Super Agent+多Sub-Agent智能体协同」驱动的架构设计。
首先说一个迪哥已经看到的明显的前提:智能体数量不是越多越好。
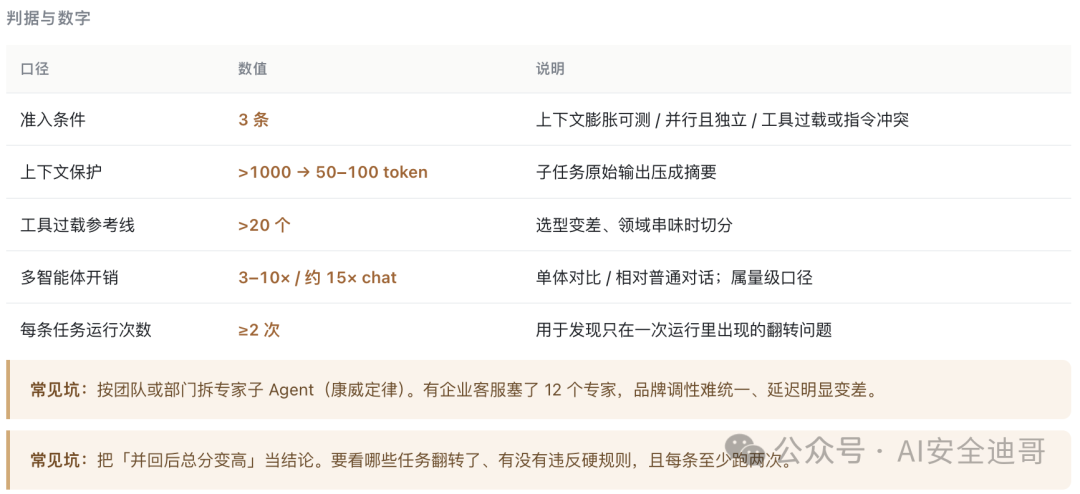
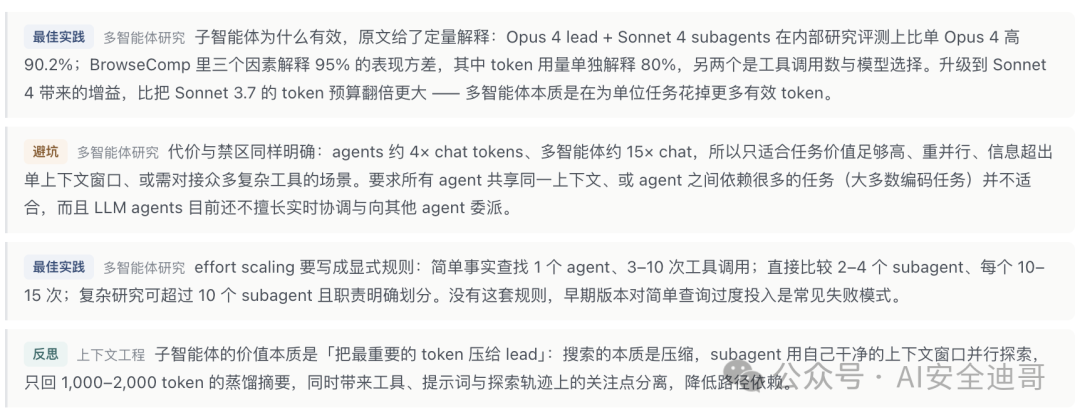
迪哥是做安全行业的,看到了很多花里胡哨的AI安全的产品,内置一百多个智能体,看起来很唬人,实际落地效果极差,最后甲方花钱卖了一个花里胡哨的玩具。这些类似的方案构建了复杂的多智能体系统,分别使用独立的智能体进行规划、执行、审查和迭代,但最终发现每次交接都会丢失上下文信息,并且协调耗费的token数远超执行预期。
一、什么场景适合多智能体架构
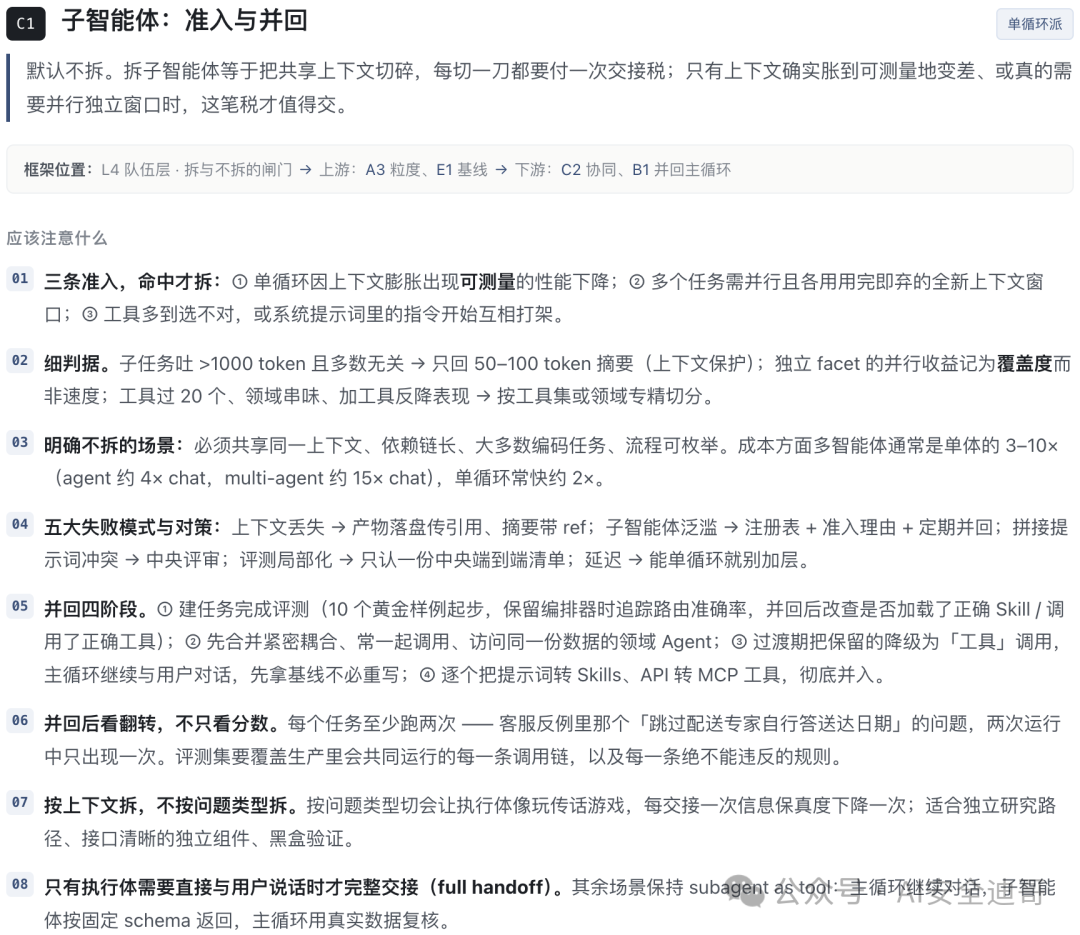
1)需要明确的上下文隔离的场景:例如单维小任务生成会产生大量上下文信息(超过10k token),但其中大部分信息与主任务无关时。
2)任务可SOP化,涉及完全不同的取数与行动范围、且有明确的信息提取标准
本质是任务委托要求可写、结果可独立验收。输入是什么、输出是什么、什么算完成都清楚,子智能体才配被当成工具调用。而反过来,如果spec模糊时把单智能体架构拆为多智能体架构,等于把「没想清楚」复制进 N 个上下文,再叠一层摘要损失,多智能体效果会远弱于单智能体。
3)查找或检索在使用前需要过滤的场景
*Search 的本质是 compression:*宽搜索、结果再进行总结、最后收窄为摘要,这本来就是一个可并行的漏斗:几个子智能体各扫一个方向,主智能体只吃过滤后的高信号内容。DeepSeek 的「两级过滤」是同一个结构:难点从来不是看见,是判断该不该让它进主窗口。
4)需要多个独立判断再比对的场景
以迪哥所在安全行业为例,安全运营的智能体需要对线索进行正辩与反比辩对综合判定与裁决,这样的情况必须多智能体独立取证并形成置信度,并行跑几份独立结论,比让一个窗口自己反驳自己更可靠。
二、多智能体设计的分离原则:以上下文分离,替代任务分离
很多人甲方喜欢用「问题、任务」来作为多智能体分离的原则,不同任务,跑不同子智能体,这样就非常容易跑偏。在分解工作时,要采取以情境为中心的视角,而非以问题为中心的视角。
反面案例:以问题为中心的分解:按工作类型划分(一个智能体编写功能,另一个编写测试,第三个审查代码)会造成持续的协调开销,它们会进行“传话游戏”,信息在每次交接过程中来回传递,每次交接都会丢失上下文。编写测试的智能体不了解某些实现决策背后的原因,而代码审查人员则缺乏探索和迭代的背景信息。
常见坑1,按组织架构图拆智能体(康威定律):按团队或用户分群切子智能体,几乎总是把技术架构照搬成了部门表;应按上下文独立性切分。
常见坑2,各智能体只优化自己的局部度量:超级智能体看到的是被稀释后或者Agent自洽后的度量结果,端到端表现反而下降。超级智能体必须维护一份完整的度量指标。
正确做法:以上下文为中心的分解:按上下文边界划分意味着处理某个特性的智能体也应该处理其测试,因为它已经拥有必要的上下文。只有当上下文能够真正隔离时,才应该进行工作拆分。有效的分解边界包括:
- 独立的研究路径:例如对“亚洲市场趋势”和“欧洲市场趋势”的研究可以并行进行,无需共同的背景信息。
- 采用独立组件和清晰的接口:有明确的API契约,前端和后端开发工作并行进行。
这里我们看下Anthropic的多智能体架构设计:
三、什么才算超级智能体?它不是一个简单的智能体管家
「超级」不是把窗口拉长、模型换贵。它是把 Agent 从「一次对话」里放出来:跨信道不断线、并行不等人、没被 @ 也会动手、崩了自己爬起来。能不能叫超级,看智能体任务中断后系统的反应。目前,国内还没发现效果好的,真实落地的超级智能体形态的产品。所以这里也只是结合海外、国内各类实践情况做下探索。
如果参考Deekseek的说法,应该是接近以下的设计架构:连续、高效、主动、持久
1、先认清超级智能体的瓶颈:单任务的上限取决于模型能力,多任务的上限取决于人的注意力。一个人通常只能同时跟进 3–5 个活跃会话;把 Agent 接到外部消息里,只是把同样的阻塞与上下文混乱搬到新界面上。
2、Session 应该是实现细节,不是用户的认知负担:用户不该操心「这条信息在哪个会话的上下文里」。前端可以只有一个聊天页,底层按上下文友好性分派多个隔离执行体。
3、把「超级」拆成可度量的能力,否则无法验收:共享世界模型、跨会话身份与记忆、全局调度与预算、主动性与机会发现、反思与经验沉淀、人机共治。
4、超级智能体看全局,这一层不要做推理:调度器、台账、经验库一旦开始生成内容,就多出一层有损摘要,且分不清结论来自执行体还是大脑。它管状态与资源,不替 lead 思考。
5、业务理解需要独立做好建模:系统凭什么听懂「把昨天那个 PR 的评审意见改完、别动配置」里对象之间是什么关系,靠的是领域本体,而非把提示词写得更细。
6、上下文边界决定实例边界:需要共享上下文的范围共用一个实例,需要隔离的范围各自配备;跨实例协作才谈 A2A,且前提是互不共享底层上下文、各自代表不同权限边界。
四、超级智能体的任务管理应该怎么做
这里其实需要区分:单次任务与多次任务,同时,Deepseek根据任务调度设计了双层架构,提到了Worker层跟Router层。那么实际在构建第三方超级体系中,他们到底如何协同任务?核心就一个:单次任务交付里共享上下文就别拆,多个任务之间才需要多智能体交互的任务管理。粒度认错了,两边的建议都会变成坏建议。
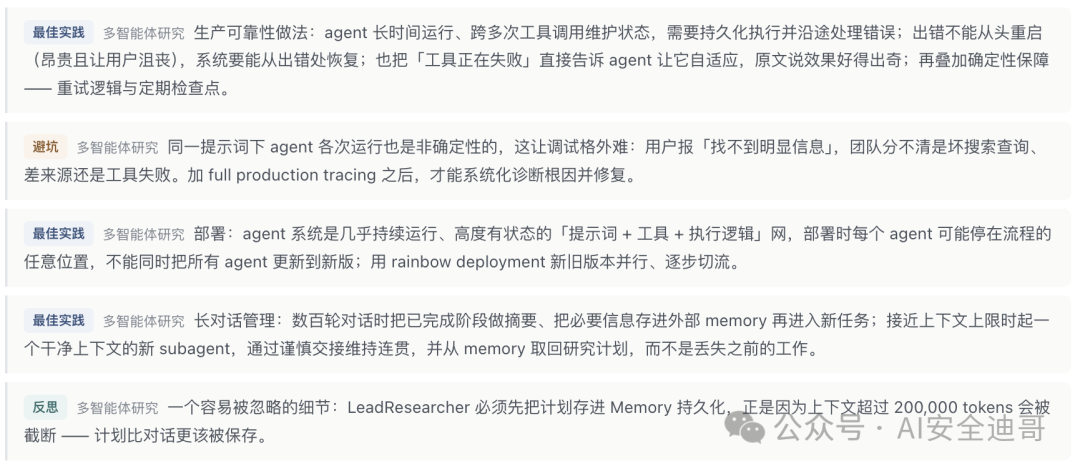
五、子智能体协同的Agent个体如何设计 步骤一:通过Loop与Harness: 稳定地让Agent的任务以SOP形式闭环
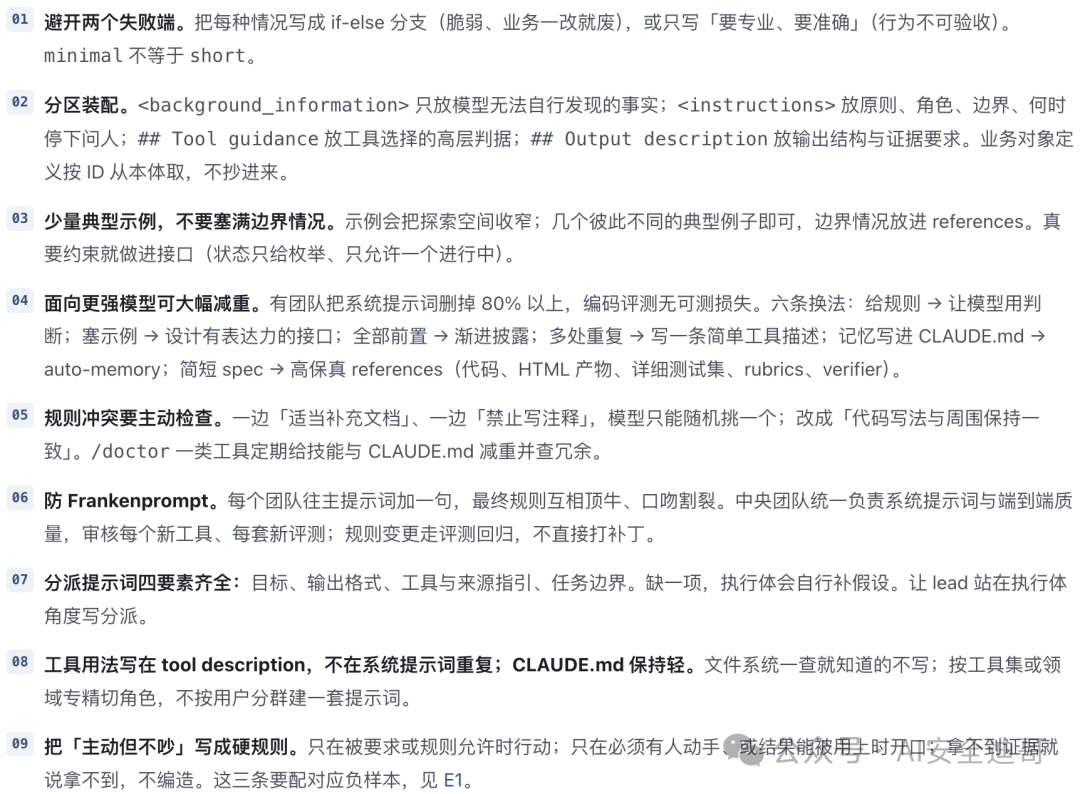
步骤二:用自适应Prompt工程来优化输入:超级智能体反馈+输入自动富化提示词
这个做法目前比较普遍了,以之前迪哥研究网络安全产品的二进制逆向分析为例,Qoder的主Agent拆分worker并完成router时,根据上下文语义,给下游的Sub-agent动态富化提示词:
 步骤三:用上下文工程,让Agent有限的注意力预算保留给高价值、高信号的token
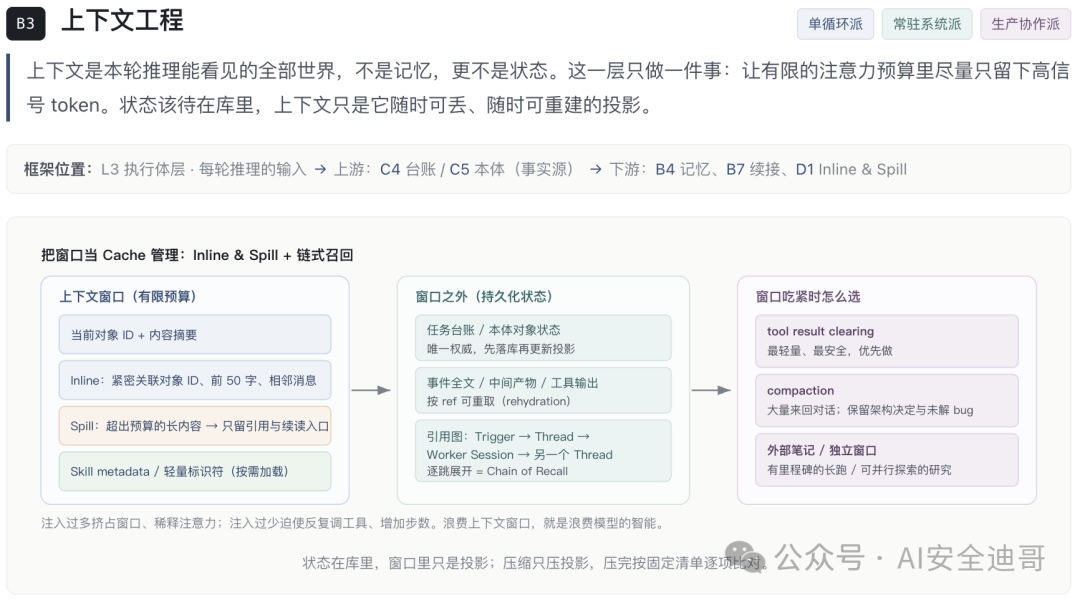
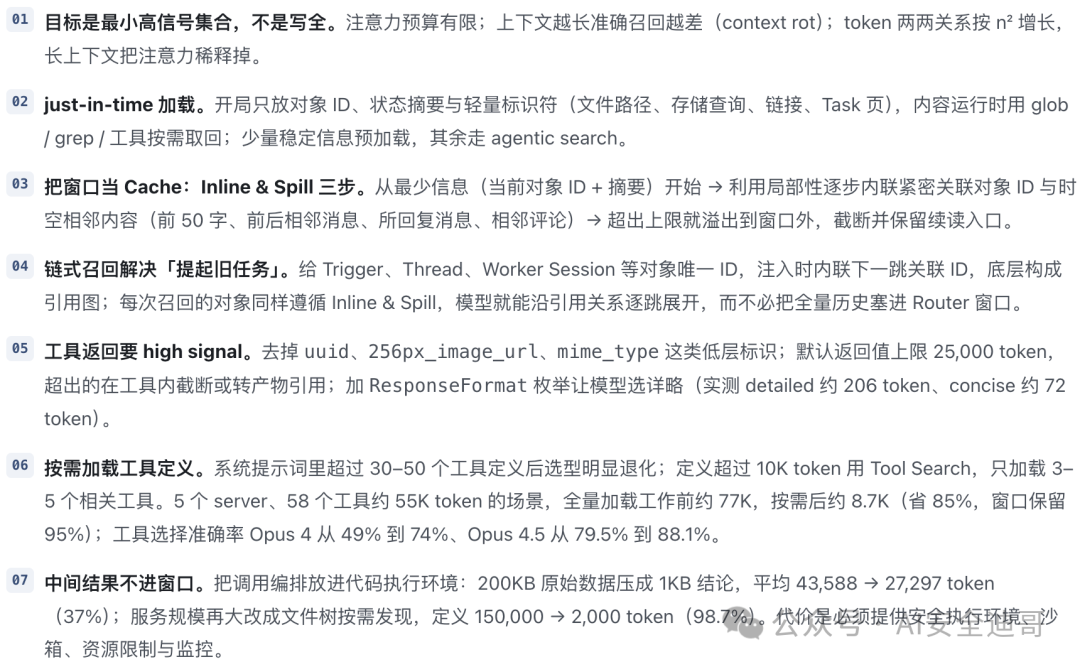
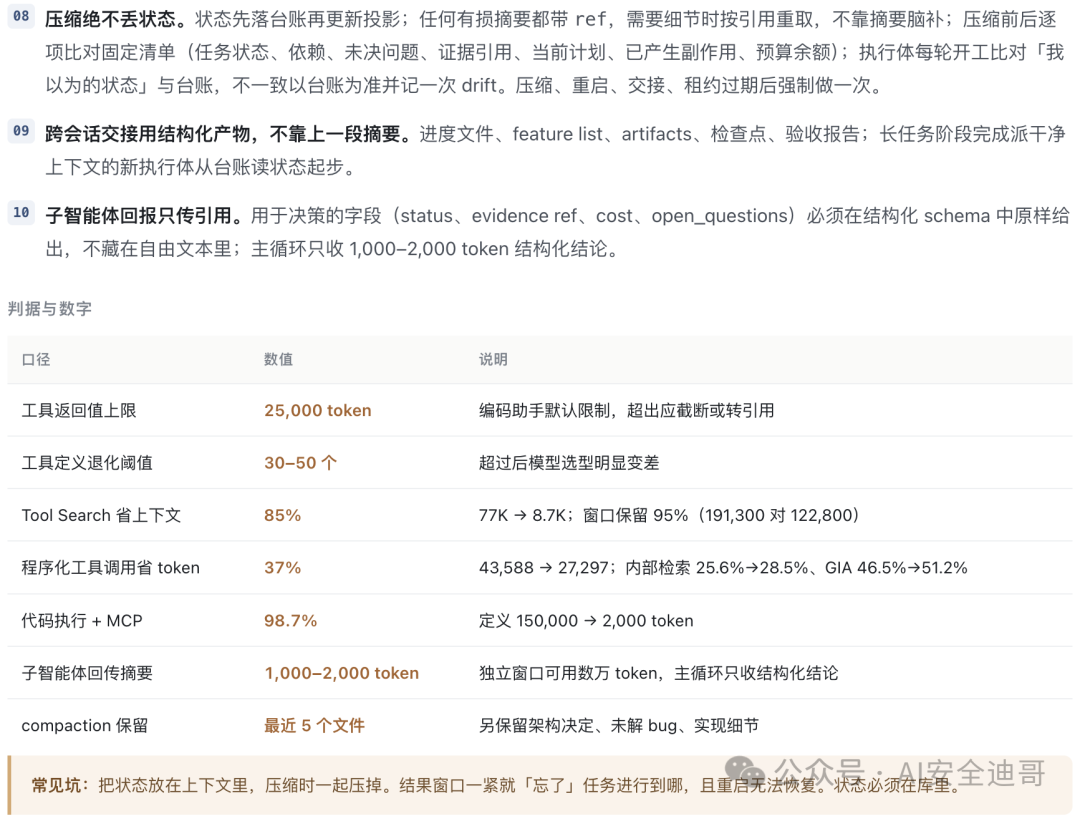 步骤四:通过记忆memory.md的设计,保住Agent关键状态、关键认知
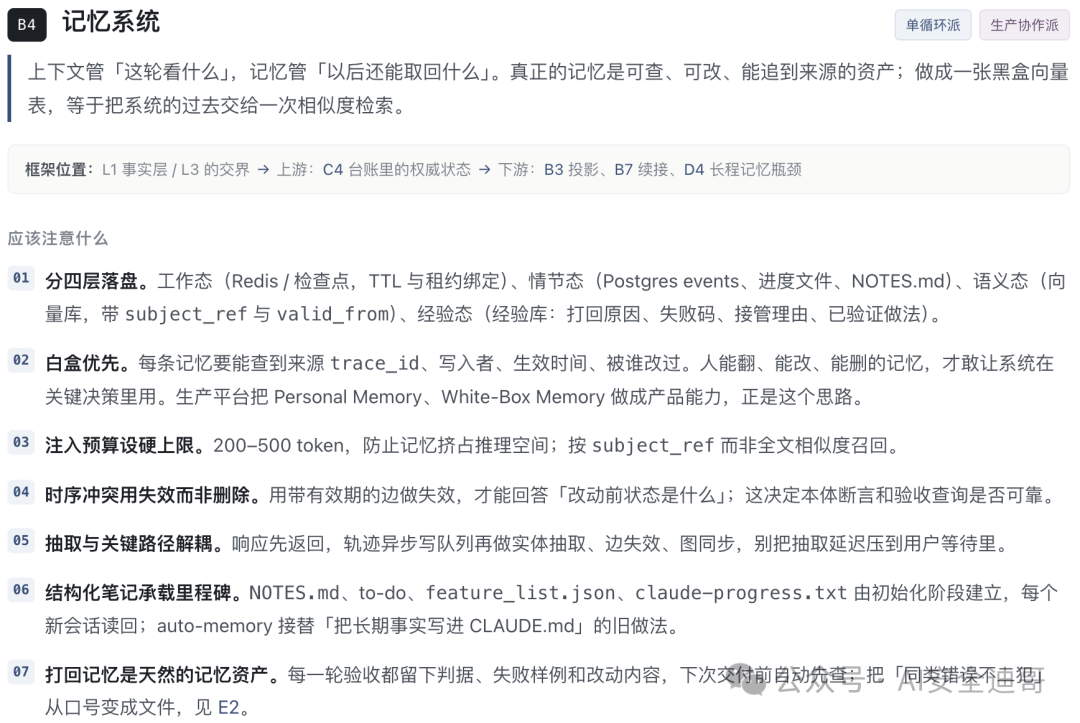
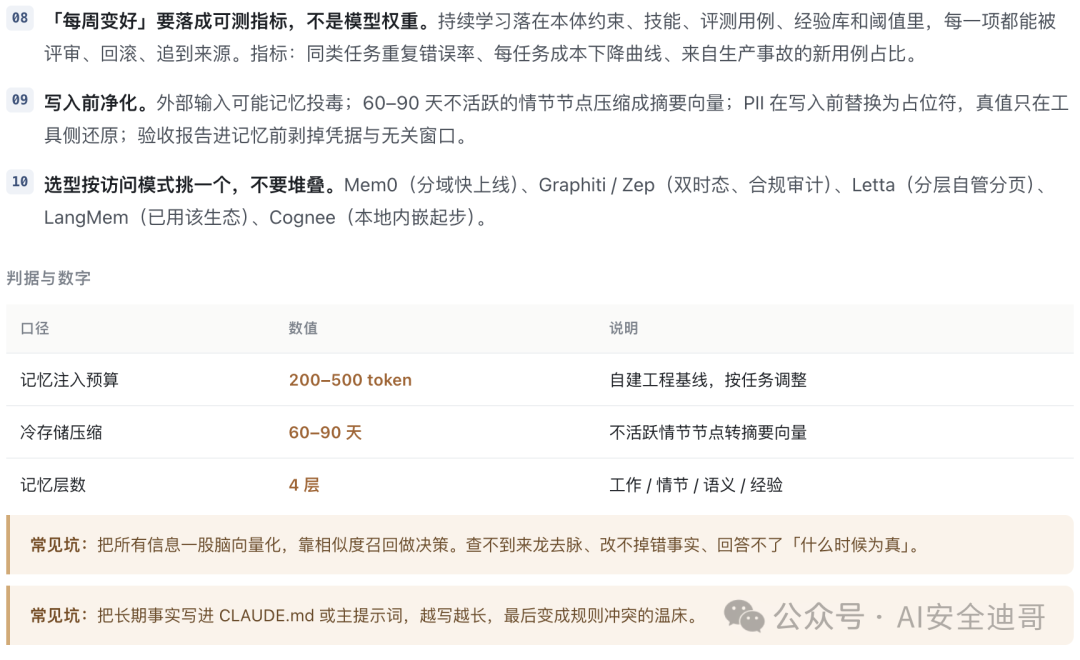
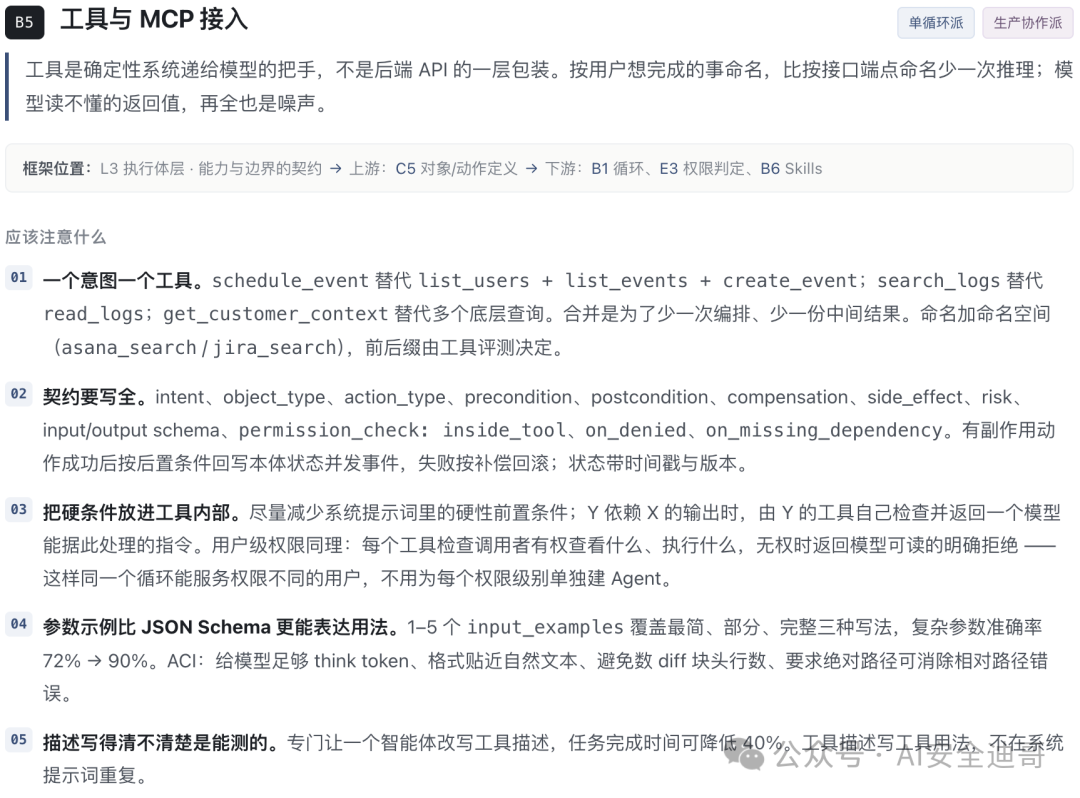
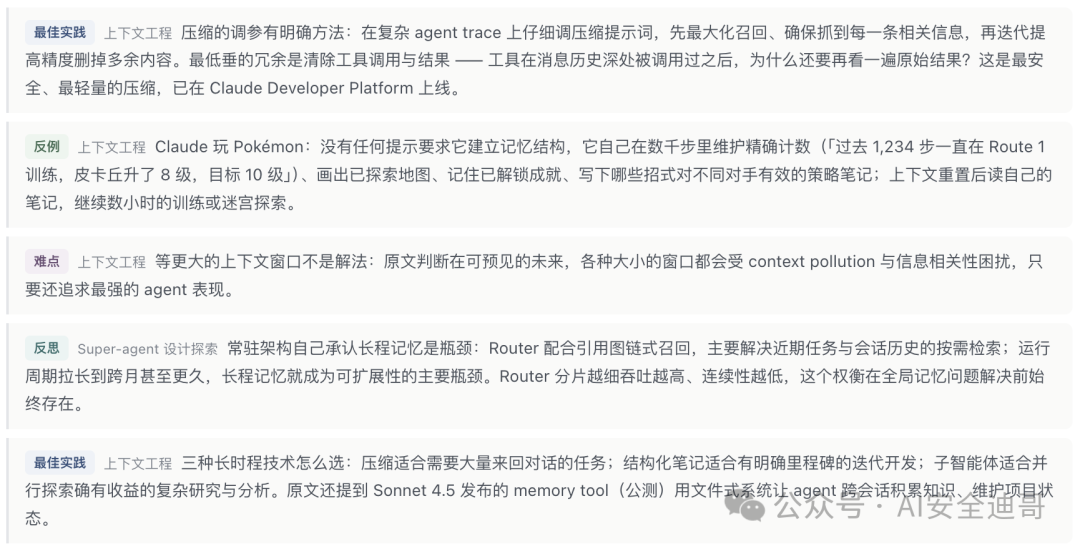 步骤五:通过工具与MCP接入控制,提升协作效率
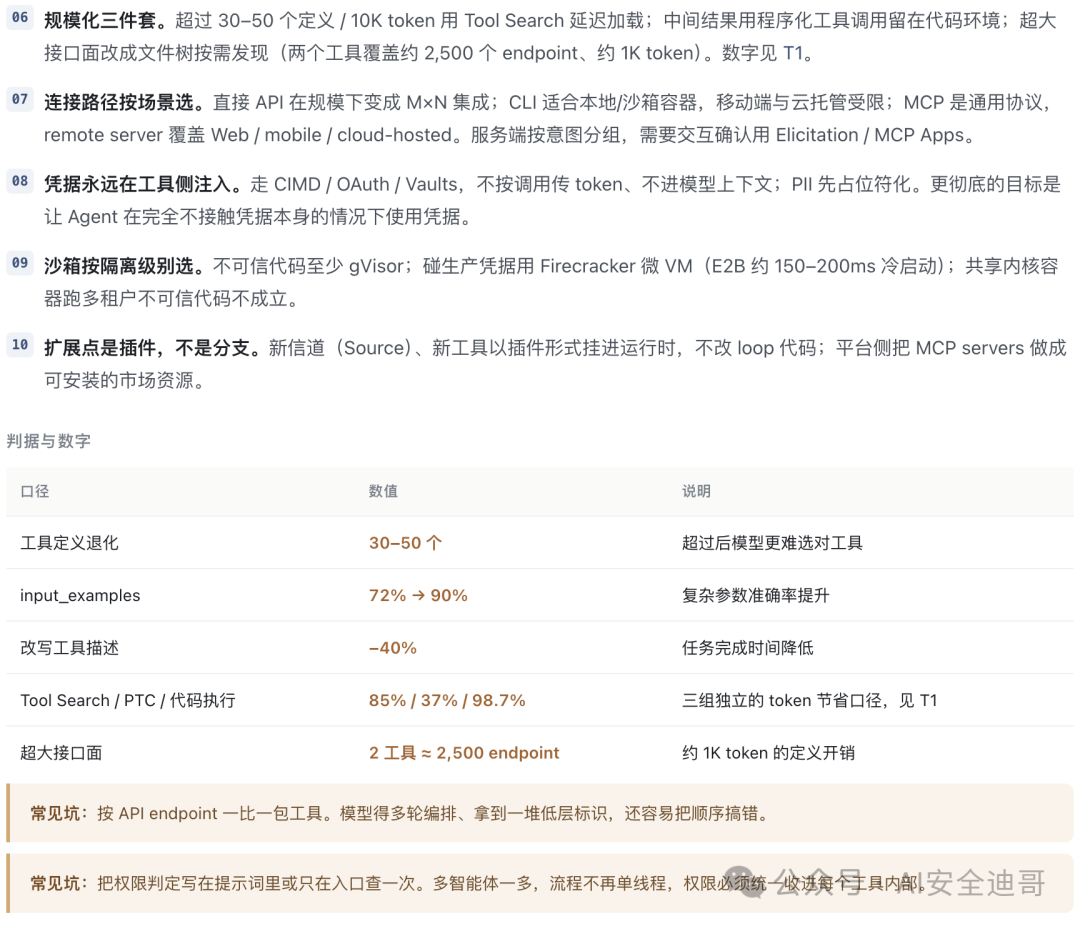
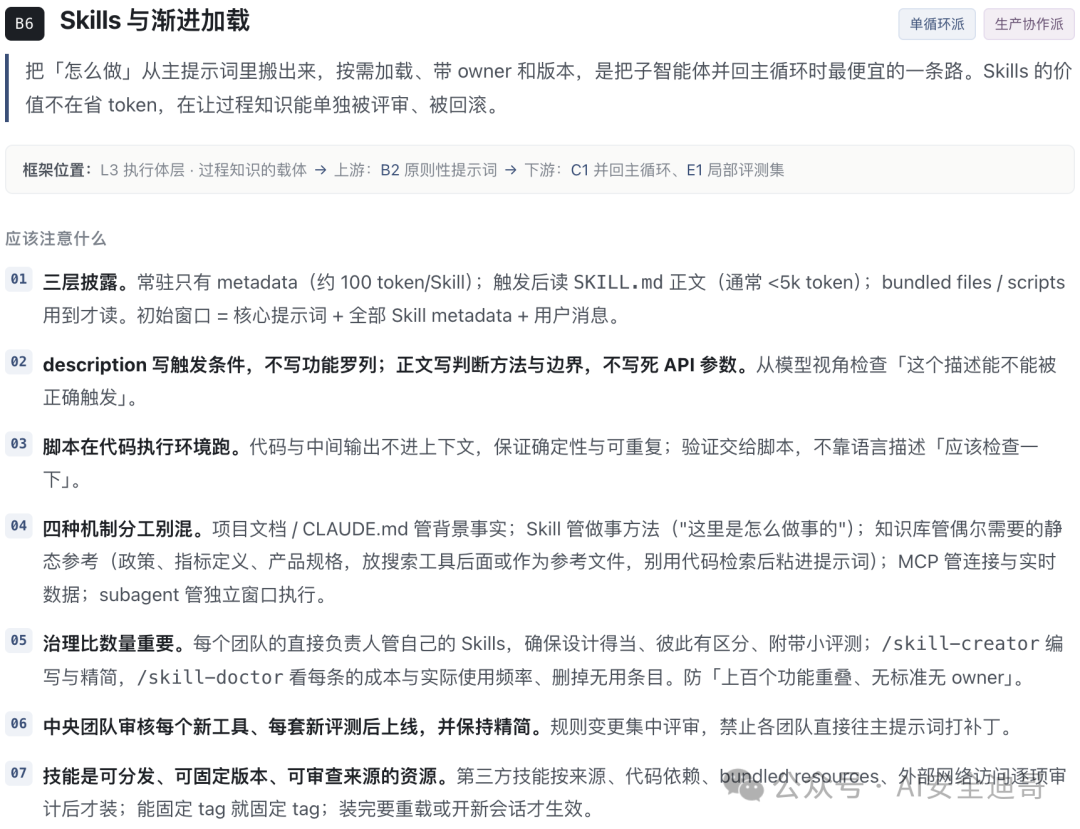
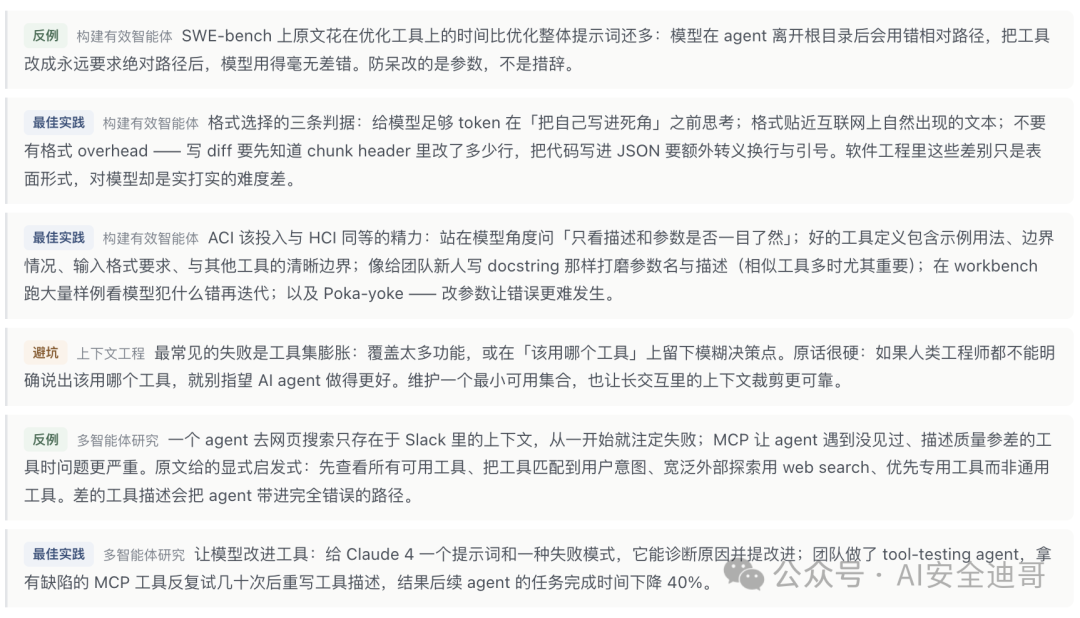 步骤六:通过Skill的渐进式披露与渐进式加载,反哺上下文工程质量 Skill的渐进式设计这个不啰嗦了,迪哥之前的文字多次提到并给出过大量实践。
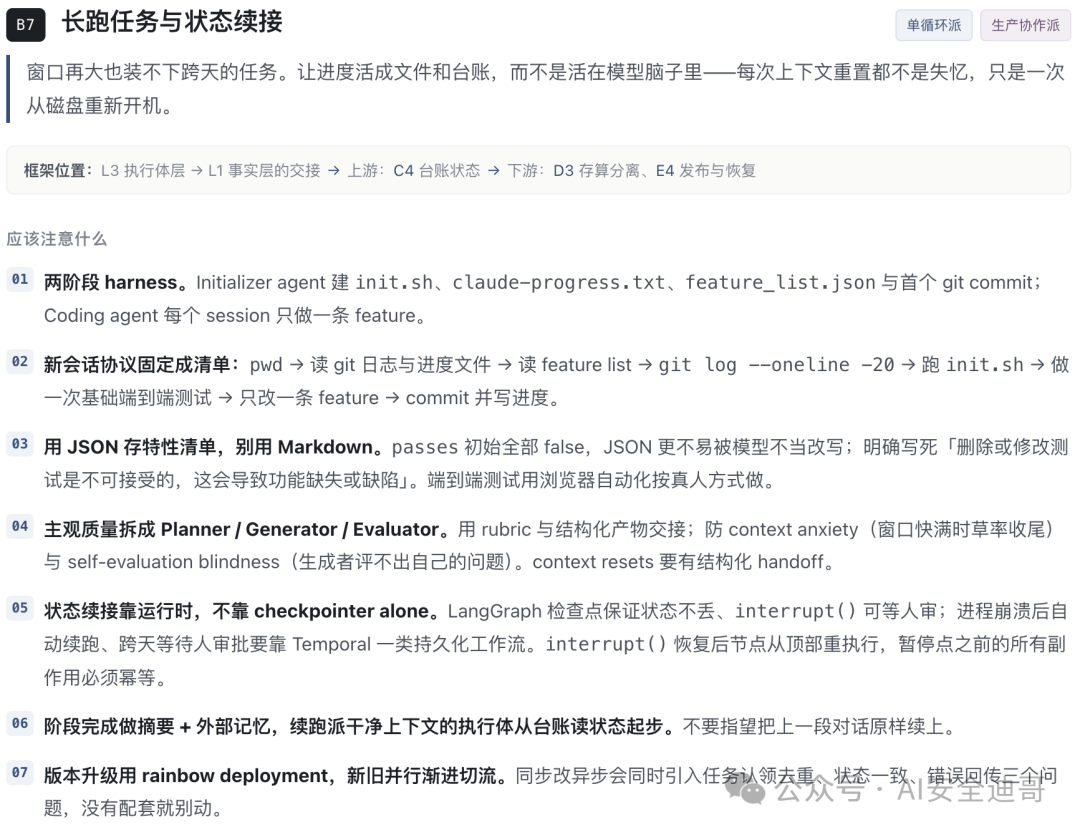
 步骤七:长状态任务的稳定性,方向纠偏能力 一般给一个非常长的任务,在超级智能体拆解后,子智能体依然会接收到一个很复杂的任务,这种情况下,越跑越偏,跑得不稳经常中断,是核心的两个问题。
 六、超级智能体与子智能体核心协同机制设计 步骤一:子智能体的准入与收回
 步骤二:设置协同与交接机制
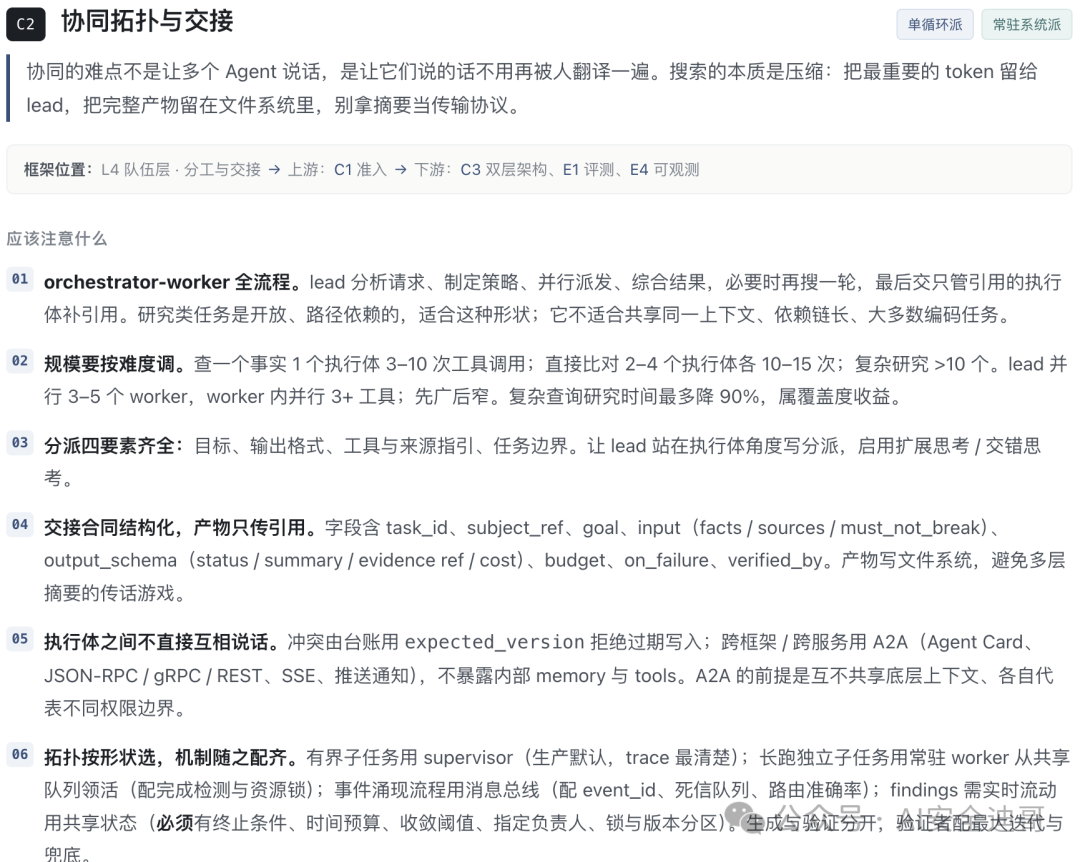
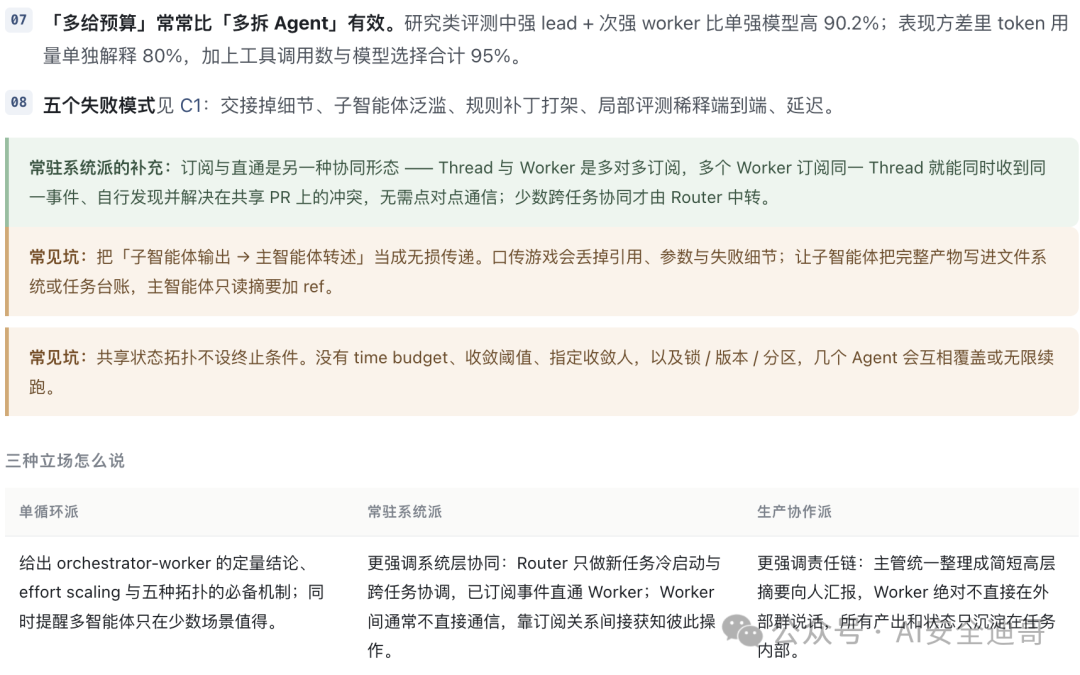
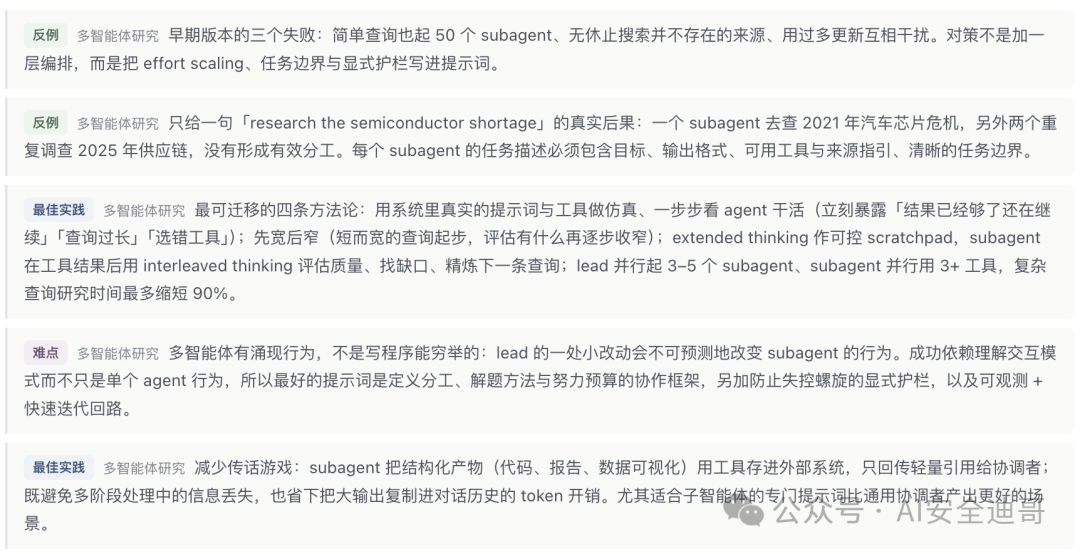 步骤三:Deepseek提到的双层架构的内化
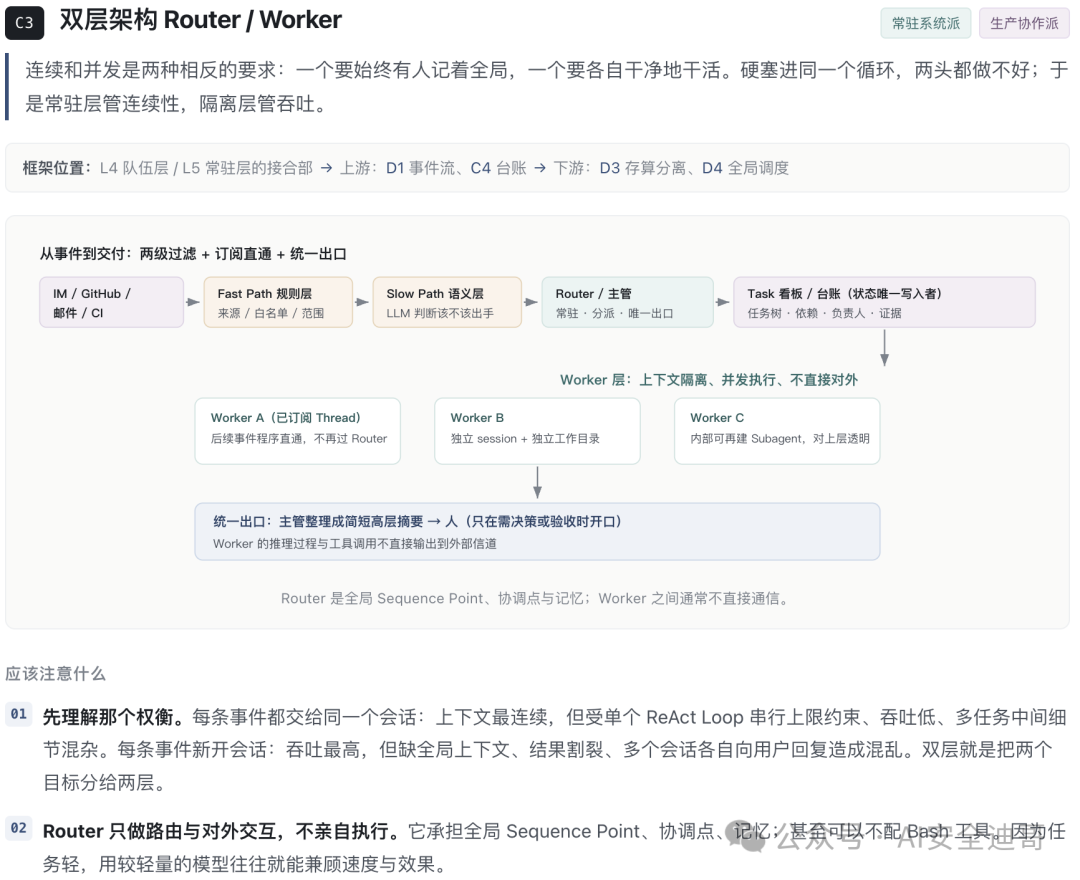
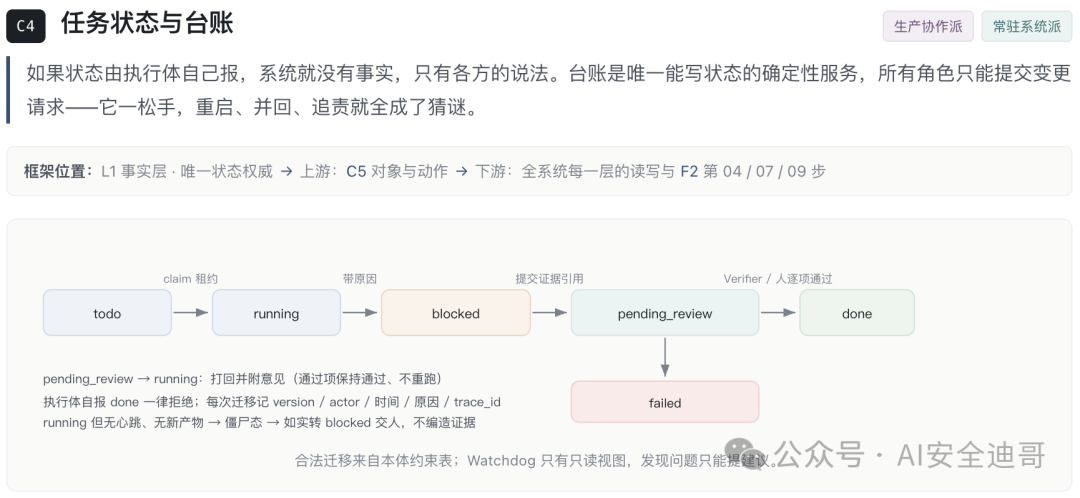
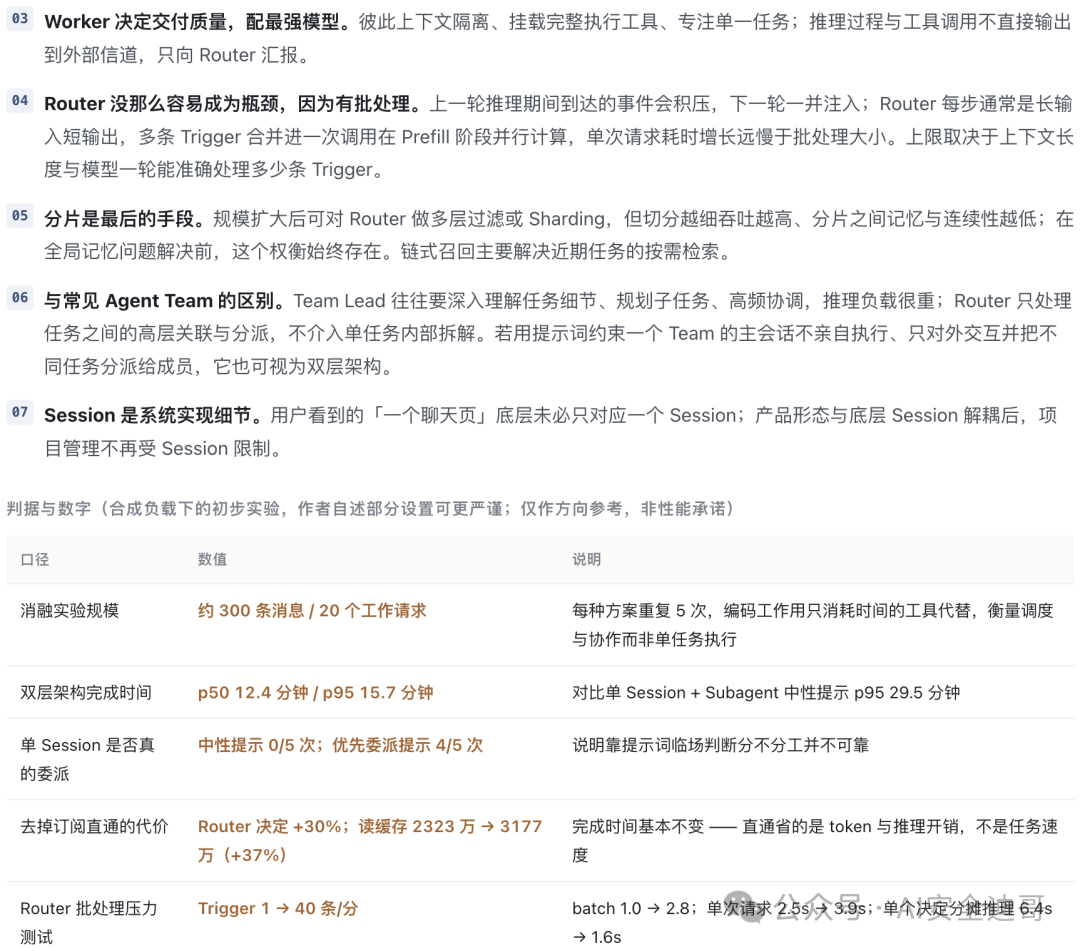 步骤五:用任务状态与台账,约束智能体执行状态
 步骤六:必须要有多业务本体 这是一个核心基线,现在有很多open-ontology类的开源项目,可以基于这些搭建。注意Palantir的本体方法现在迪哥看未必是最合适的,因为它诞生在AI之前。

版权声明
本站仅做备份收录,仅供研究与教学参考之用。
读者将信息用于其他用途的,全部法律及连带责任由读者自行承担,本站不承担任何责任。








评论